En quelques années, l’intelligence artificielle générative a réalisé des progrès spectaculaires. Elle est aujourd’hui capable de produire des textes et des images d’une qualité stupéfiante. Elle trouve également des applications dans des domaines aussi variés que la création artistique ou la recherche pharmaceutique. Mais comment expliquer de telles performances ? Comment mesurer la précision des modèles utilisés ? Et surtout, comment ces méthodes parviennent-elles à traiter des données de très grande dimension, alors que les difficultés statistiques augmentent généralement avec celle-ci ?
Ces questions sont au cœur des recherches menées au Centre de recherche en économie et statistique (CREST), qui contribue au rayonnement international de l’Institut Polytechnique de Paris (IP Paris). Parmi les approches étudiées figurent les modèles de diffusion, qui reposent sur une idée originale : apprendre à inverser un processus aléatoire pour générer de nouvelles données. Des travaux récents de chercheurs du CREST permettent de mieux comprendre les garanties mathématiques de ces méthodes, notamment les erreurs liées à leur mise en œuvre numérique et le rôle de la dimension des données.
À travers ces recherches, c’est une facette parfois méconnue de l’IA générative qui apparaît : celle d’un domaine où la statistique, les probabilités et l’analyse numérique jouent un rôle essentiel pour comprendre les performances des algorithmes et en cerner les limites.
Une équipe de recherche de premier plan
Peu de gens le savent : l’Institut Polytechnique de Paris figure parmi les 30 meilleures universités au monde en statistique, selon le classement thématique de Shanghai.
Cette reconnaissance internationale vient saluer le travail des équipes de recherche, et notamment celui du Centre de recherche en économie et statistique (CREST), créé en 1988 : près de la moitié des statisticiens d’IP Paris sont membres du CREST et enseignants-chercheurs à l’ENSAE Paris.
Dirigée par Alexandre Tsybakov de 2010 à 2024, l’équipe de statistique du CREST s’est considérablement développée au cours de cette période. Elle réunit aujourd’hui une douzaine de chercheurs qui travaillent sur des sujets variés : réduction de dimension, échantillonnage, optimisation stochastique, équité, confidentialité ou encore apprentissage séquentiel. Cette diversité reflète l’élargissement du champ de la statistique, désormais étroitement lié aux questions soulevées par l’intelligence artificielle et l’apprentissage automatique.
Plusieurs membres de l’équipe ont reçu des distinctions internationales ou occupent des responsabilités éditoriales dans des revues scientifiques de référence. Cristina Butucea, Nicolas Chopin et Alexandre Tsybakov sont Fellows of the Institute of Mathematical Statistics, un titre prestigieux dans la communauté scientifique. Nicolas Chopin est par ailleurs l’un des trois rédacteurs en chef du Journal of the Royal Statistical Society: Series B (JRSS B), l’une des principales revues de statistique. Autre signe de ce rayonnement scientifique, Anna Korba et Arnak Dalalyan ont chacun obtenu une bourse du Conseil européen de la recherche (ERC), dotée d’environ 1,5 million d’euros sur cinq ans. Leurs projets portent sur l’étude des propriétés mathématiques de l’intelligence artificielle générative, un domaine de recherche en pleine expansion.
Les modèles de diffusion : du hasard à la création
L’intelligence artificielle générative a fait une entrée remarquée dans notre quotidien. Des outils comme ChatGPT, Claude ou Midjourney permettent désormais de produire, en quelques instants, des textes, des images ou même de la musique d’une qualité souvent saisissante. Dès 2022, une œuvre réalisée avec l’aide de l’IA générative Midjourney, Théâtre d’opéra spatial, remportait le premier prix d’un concours d’art numérique organisé dans le Colorado, aux États-Unis. Dans la recherche pharmaceutique, l’IA générative est notamment utilisée pour concevoir de nouvelles molécules susceptibles de devenir des médicaments. Derrière ces prouesses se cachent pourtant des questions fondamentales : comment ces modèles fonctionnent-ils réellement ? Pourquoi sont-ils aussi performants ? Et peut-on garantir la fiabilité de leurs résultats ?
Parmi les approches qui ont révolutionné l’IA générative figurent les modèles de diffusion, fondés sur une idée mathématique aussi surprenante que puissante : inverser un processus de diffusion aléatoire. Cette approche, au cœur des travaux de plusieurs chercheurs du CREST, sera expliquée plus en détail dans la suite de cet article.
Mais avant d’entrer dans le vif du sujet, commençons par une expérience toute simple. Nous avons demandé à ChatGPT de générer une image illustrant la notion de variance, en lui soumettant quatre fois exactement la même instruction : « Génère une image de la variance ». Voici les quatre résultats obtenus :
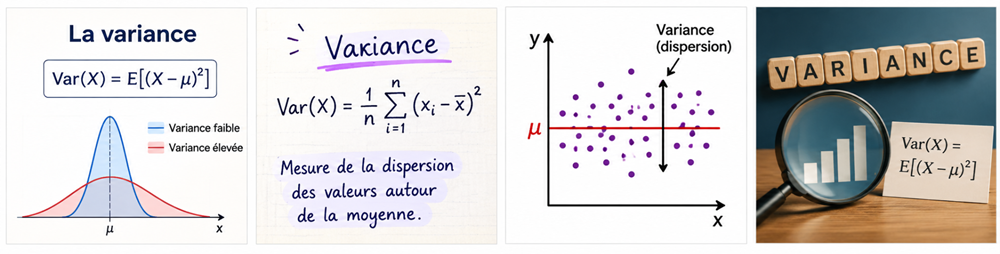
Figure 1. Quatre images produites par ChatGPT à partir de l’instruction : « Génère une image de la variance ». La diversité des résultats illustre le caractère aléatoire de l’IA générative.
Chacune de ces quatre images résulte d’un tirage aléatoire selon une loi de probabilité dépendant de l’instruction fournie. Mais quel rapport avec les processus de diffusion ? Ces derniers décrivent notamment le mouvement d’une particule dans l’espace, dont la dynamique est caractérisée par deux fonctions : la dérive et le coefficient de diffusion. Convenablement choisies, ces fonctions garantissent que la loi de la position de la particule converge, à une vitesse exponentielle, vers la loi gaussienne standard, quelle que soit sa distribution initiale. Une image peut être vue comme un point dans un espace de très grande dimension, chaque coordonnée correspondant à l’intensité d’un pixel. Ainsi, si l’on part d’une image tirée au hasard parmi celles représentant la variance et qu’on la fait évoluer selon un tel processus, on obtient, après un temps suffisamment long, un objet dont la distribution est proche d’une loi gaussienne standard.
Le lien entre les processus de diffusion et l’IA générative apparaît alors clairement : si l’on parvenait à inverser la dynamique du processus de diffusion, il suffirait de tirer un vecteur aléatoire selon la loi gaussienne standard et de le faire évoluer selon cette dynamique inversée pour obtenir une image tirée au hasard parmi celles représentant la variance. Mais une telle inversion est-elle mathématiquement possible ?
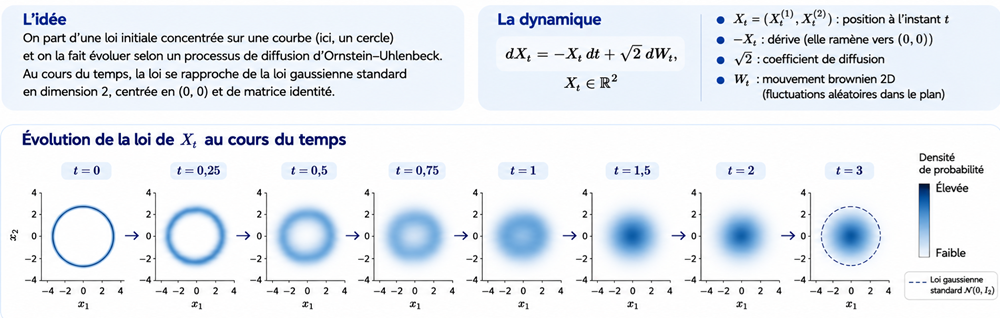
Figure 2. Illustration d’un processus de diffusion : au fil du temps, une loi de probabilité initialement concentrée sur un cercle évolue vers une loi gaussienne standard. Cet exemple montre comment une distribution portée par une variété de faible dimension peut progressivement se diffuser dans l’espace ambiant.
Une autre propriété remarquable des processus de diffusion vient à notre secours : lorsqu’on inverse le temps, on obtient, sous certaines conditions, un nouveau processus de diffusion, dont le coefficient de diffusion reste inchangé et dont la dérive admet une formule explicite. Le problème semble donc résolu.
Les deux défis : statistique et numérique
Pourtant, deux difficultés majeures subsistent. La première est statistique : la dérive du processus inversé dépend de la loi initiale, qui nous est inconnue. Dans notre exemple, il s’agit de la loi des images représentant la variance. Or, un programme d’IA générative ne connaît pas toutes les images possibles correspondant à cette instruction : il doit apprendre à en reproduire la distribution à partir d’exemples. La loi initiale constitue donc ce que les statisticiens appellent un paramètre fonctionnel inconnu.
La seconde difficulté est numérique : un processus de diffusion évolue en temps continu, tandis qu’un ordinateur ne peut effectuer qu’un nombre fini de calculs. Il faut donc discrétiser sa dynamique, c’est-à-dire remplacer l’évolution continue par un nombre fini d’étapes temporelles successives.
En résumé, l’IA générative fondée sur les modèles de diffusion fonctionne en deux étapes. D’abord, un ensemble d’exemples, appelé échantillon d’entraînement, permet d’estimer la dérive du processus inversé. Ensuite, un vecteur est tiré aléatoirement selon la loi gaussienne standard, puis transformé en appliquant la dynamique inverse estimée et discrétisée.
Les travaux de plusieurs équipes dans le monde, dont celle du CREST, visent notamment à comprendre comment la précision de cette procédure dépend de deux paramètres essentiels. Le premier est la taille de l’échantillon d’entraînement : plus elle est faible, plus l’estimation de la dérive risque d’être imprécise. Comment quantifier cette perte de précision et construire des estimateurs atteignant les meilleures performances théoriquement possibles ? Le second est le nombre d’étapes de discrétisation : trop peu d’étapes peuvent éloigner la dynamique simulée de la diffusion véritable. Comment mesurer cette erreur et déterminer le nombre d’étapes nécessaires pour garantir une précision donnée ? À ces difficultés s’ajoute la malédiction de la dimension : dans les problèmes d’estimation de paramètres fonctionnels, la taille de l’échantillon nécessaire pour garantir une précision donnée peut croître exponentiellement avec la dimension. Ce phénomène représente un défi majeur pour l’IA générative, où les images sont représentées par des vecteurs comportant parfois des millions de coordonnées.
Des garanties mathématiques pour l’IA générative
Un résultat récent, obtenu par Vahan Arsenyan, Elen Vardanyan et Arnak Dalalyan, présenté à la conférence internationale NeurIPS en 2025, apporte un éclairage important sur la précision des modèles de diffusion. Les auteurs montrent notamment que, sous certaines conditions, l’erreur liée à la discrétisation décroît comme l’inverse du nombre d’étapes temporelles. Autrement dit, doubler ce nombre permet de diviser approximativement cette erreur par deux.
L’un des points forts de ce résultat est qu’il ne nécessite pas que la loi des données possède une densité strictement positive partout. Il s’applique ainsi à des situations où les données sont concentrées sur une variété de faible dimension, c’est-à-dire une surface ou une structure géométrique occupant une petite partie de l’espace ambiant.
Prenons une image en niveaux de gris de résolution 128 × 128 pixels : elle correspond à un vecteur de dimension 16 384. Pourtant, il est plausible que les images représentant des objets naturels se concentrent près d’une variété de dimension bien inférieure. Cette hypothèse pourrait contribuer à expliquer pourquoi les modèles génératifs restent performants malgré la très grande dimension des images.
Cette idée fait écho à un autre travail d’Arnak Dalalyan, réalisé avec Nicolas Schreuder et Victor-Emmanuel Brunel, consacré aux Wasserstein GAN, les Réseaux antagonistes génératifs, basés sur la distance de Leonid Wasserstein (1969), une autre famille de modèles génératifs. Les auteurs ont établi des garanties statistiques dans lesquelles la précision dépend de la dimension intrinsèque des données, plutôt que de celle de l’espace ambiant. En particulier, sous leurs hypothèses, l’erreur décroît à une vitesse de l’ordre de n−1/d, où n désigne la taille de l’échantillon d’entraînement et d la dimension intrinsèque.
Obtenir des garanties comparables pour les modèles de diffusion constitue aujourd’hui une direction de recherche active et particulièrement prometteuse. L’enjeu est de comprendre comment ces modèles peuvent exploiter la structure géométrique des données pour échapper, au moins partiellement, à la malédiction de la dimension.
Ces recherches illustrent le rôle essentiel des mathématiques dans le développement de l’intelligence artificielle. Derrière les performances des modèles génératifs se cachent des questions fondamentales de statistique, de probabilités et d’analyse numérique. En cherchant à y répondre, les chercheurs du CREST contribuent non seulement à mieux comprendre les méthodes actuelles, mais aussi à poser les bases d’une IA générative plus fiable et mieux maîtrisée.
Pour aller plus loin
Arsenyan V., Vardanyan E. et Dalalyan A. (2025). Assessing the Quality of Denoising Diffusion Models in Wasserstein Distance: Noisy Score and Optimal Bounds. Conference on Neural Information Processing Systems.
Marion P., Korba A., Bartlett P. et al. (2025). Implicit Diffusion: Efficient Optimization through Stochastic Sampling. International Conference on Artificial Intelligence and Statistics.
Schreuder N., Brunel V.-E. et Dalalyan A. (2021). Statistical Guarantees for Generative Models without Domination. International Conference on Algorithmic Learning Theory.
Dossier Statistiques 2 – Sommaire :
-
-
- Editorial
- Droit et statistique : une liaison plus que centenaire
- Un degré de plus ou de moins, ça change quoi ? Ce que la météo révèle de nos comportements et de l’économie
- L’apprentissage bayésien à l’heure des LLM
- Entretien avec Anna Korba
- Le CREST au cœur des mathématiques de l’IA générative
- Calcul quantique : quels enjeux pour l’économie française dans ce secteur naissant ?
- IA et Enseignement supérieur
-
- Le CREST au cœur des mathématiques de l’IA générative - 6 novembre 2026
