Jérôme Tassi est avocat au cabinet AGIL’IT, et spécialiste en propriété intellectuelle
Philippe Tassi a été professeur-chercheur à l’Ensae, DGA de Médiamétrie, et est actuellement membre de la Commission Nationale des Sondages
La statistique et la probabilité n’ont pas pour seul objectif la compréhension et la description du réel : ce sont des instruments de connaissance. Leur mode de fonctionnement et de raisonnement (observation, modélisation, …) se retrouve dans de multiples domaines : démographie, économie, finance, médecine et biométrie, marketing, physique, sciences humaines ou sociales, climatologie, etc.
Elles prennent place également en droit où elles sont à la fois objet de régulation, instrument de preuve, outil de gouvernement, valeur économique, parfois vecteur de discrimination. Elles mesurent, quantifient ou qualifient des comportements, comme le nombre de délits par type donné, agrègent des trajectoires individuelles, fondent des politiques publiques, nourrissent des modèles prédictifs ou de causalité, éclairent des expertises judiciaires et participent à la fabrication de décisions publiques ou privées.
Statistique, probabilité et droit font face à une double exigence : contribuer au développement de la connaissance pour les deux premières, empêcher que cette connaissance ne transforme les nécessaires données individuelles en une atteinte aux droits fondamentaux pour le troisième, dans un monde devenu numérique.
Nous emploierons le mot statistique au sens très large, pour parler à la fois de recueil de données et de comptage, mais aussi de probabilité, statistique et modélisation. Nous allons aborder successivement le XIXème siècle, la deuxième partie du XXème siècle dominée par l’informatique, et le monde actuel numérique.
1 – Au dix-neuvième siècle
Deux siècles avant le XIXème siècle, le XVIIème siècle est une époque où la culture – quand elle existe – est générale ; un premier exemple de lien entre droit et sciences est donné par Pierre de Fermat (1607 – 1665) : magistrat, commissaire aux requêtes au parlement de Toulouse, puis conseiller à la première chambre des enquêtes, de 1631 à 1637, et il devient alors conseiller à la chambre de l’édit, à Castres ; mais Fermat est également célèbre pour ses énoncés mathématiques (sa dernière « intuition », dénommée le « grand théorème de Fermat », ne sera démontrée qu’en 1994) (Singh [17]).
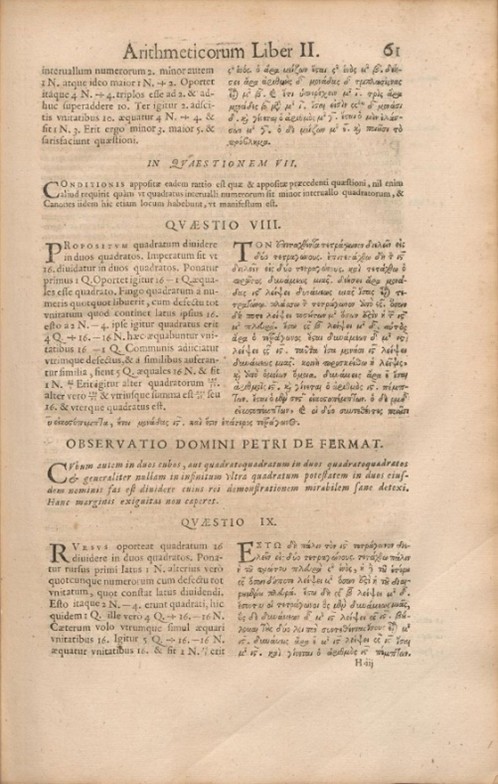
Enoncé du « grand théorème de Fermat » (1670, réédition) Observatio Domini Petri de Fermat
Si Fermat s’intéresse à la fois au droit et aux sciences, il ne les met pas en relation. Le langage commun entre le droit et la statistique remonte a minima au XIXème siècle.
Un nom en est le symbole : celui de Siméon Denis Poisson (1781 – 1840). C’est un mathématicien français, à la fois ouvert aux théories mathématiques et aussi à leurs applications en physique, en astronomie, et en droit. Entrant major à l’Ecole Polytechnique en 1798 (il a 17 ans), il en deviendra professeur en 1806.
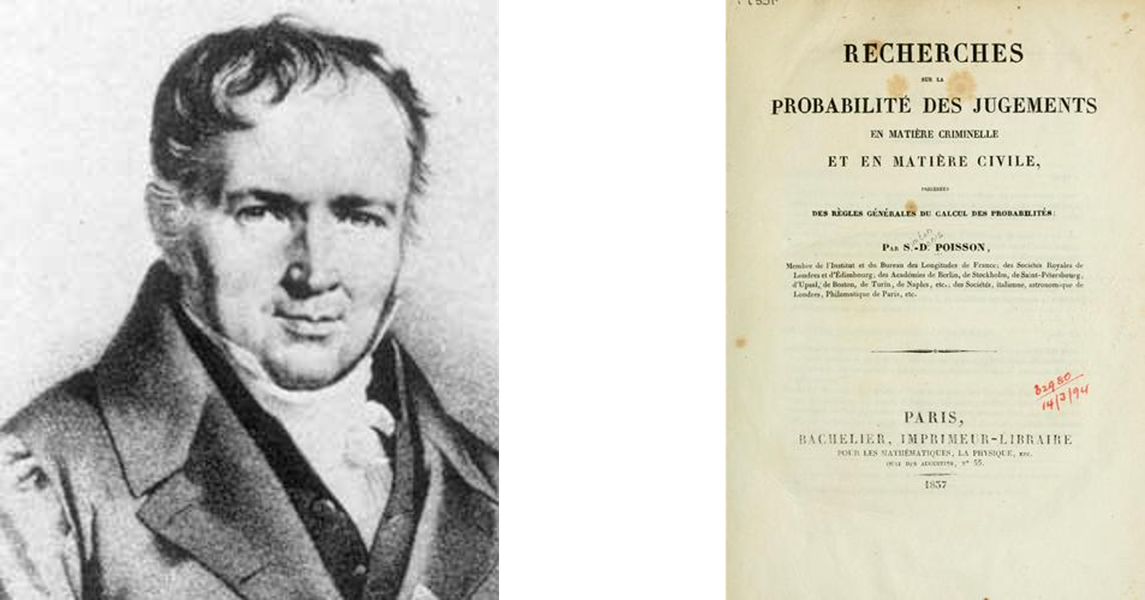
Siméon Denis Poisson Première page du livre de Poisson (1837)
En 1837, il publie aux Editions Bachelier, 55 quai des Augustins, à Paris, un ouvrage mêlant droit et statistique, intitulé « Recherches sur la probabilité des jugements en matière criminelle et en matière civile », en cinq chapitres. C’est dans cette publication qu’apparaît la célèbre loi de Poisson comme processus de dénombrement d’événements de même nature survenant par unité de temps, le mot loi étant à prendre non pas dans le sens légal mais au sens mathématique.
Les quatre premiers chapitres sont des éléments de probabilité – Poisson est passionné de pédagogie, de vulgarisation et de transmission –, le cinquième est intitulé « Application des règles générales des probabilités aux décisions des jurys et aux jugements des tribunaux ».
Dans la table des matières de son imposant ouvrage (415 pages, dont 97 pour le seul chapitre 5), il précise sa vision :
« On détermine les probabilités qu’un accusé sera condamné ou acquitté ….. par des jurés dont chacun a une probabilité de ne pas se tromper, et en ayant égard à la probabilité, ainsi donnée, de la culpabilité qui avait lieu avant le jugement. Par la règle de la probabilité des causes ou des hypothèses, on détermine également la probabilité que l’accusé, ainsi condamné ou acquitté, est coupable ou innocent. »
La probabilité des causes (probabilité conditionnelle : P(A/B) et P(B/A)) à laquelle Poisson fait allusion est une innovation majeure du XVIIIème siècle, due au pasteur et mathématicien anglais Thomas Bayes (1702 – 1761). Ce résultat sera publié après sa mort, en 1763, et fait toujours partie des bases des modèles les plus récents de la mathématique statistique.
En outre, la liaison entre droit et statistique est confirmée car, en bas de la page 318, Poisson fait référence au mathématicien russo-ukrainien Mikhaïl Ostrogradski (1801 – 1862) qui a traité le même sujet en 1834, dans le cadre de l’Académie de Saint Petersbourg. Ostrogradski a été enseignant au Lycée Henri IV à Paris et il connaît bien Poisson, qui a été son co-directeur de thèse avec Cauchy.
Certes, les écrits de Poisson sont très mathématisés (et difficilement lisibles pour l’époque tant il est virtuose) ; il commence par étudier le cas d’un seul juré, avec le calcul de la probabilité de condamnation de l’accusé, ainsi que la probabilité que le juré ne se trompe pas. Il passe ensuite au cas de deux jurés, puis de trois (ce qui lui permet d’aborder les notions d’unanimité ou de majorité de décision), et enfin de n jurés avec des majorités variables de décision. Ses équations sont souvent complexes, intégrant de nombreux paramètres qu’il convient d’estimer (mais les méthodes d’estimation sont alors balbutiantes).
En fin de XIXème siècle, mentionnons également un article publié en 1891 par Fernand Faure dans la Revue Internationale de l’Enseignement (Tome 22), intitulé « La statistique dans les Facultés de droit ». Faure (1853 – 1929) est avocat, docteur en droit et agrégé, professeur d’économie ; il est aussi homme politique. La Revue est publiée par la Société de l’Enseignement Supérieur, dont le président est Marcellin Berthelot, membre de l’Institut et sénateur. Faure y expose les définitions de la statistique et ses fonctions, dans le contexte des échanges et débats de l’époque.
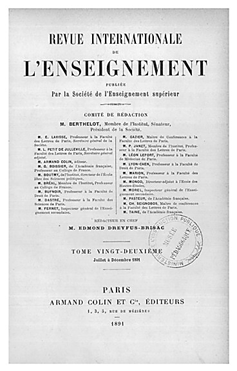
Revue Internationale de l’Enseignement, 1891
Rappelons que la statistique, en cette fin de dix-neuvième siècle, est essentiellement de nature administrative : le premier Bureau de la Statistique voit le jour en 1801, puis revient sous l’appellation Statistique Générale de la France (SGF) en 1833 puis Service national des Statistiques pendant la deuxième guerre mondiale, avant la création de l’INSEE en 1946.
Elle devient peu à peu une science proche de la recherche mathématique dans la deuxième partie de XIXème siècle, par exemple grâce aux avancées du belge Adolphe Quetelet (1796 – 1874) ou des britanniques Francis Galton (1822 – 1911) et Karl Pearson (1857 – 1936) puis, au début du siècle suivant avec les travaux de Sir Ronald Fisher (1890 – 1962), Jerzy Neyman 1894 – 1981), Egon Pearson (1895 – 1980), puis les débuts de la modélisation avec l’économétrie en 1933.
2 – Le virage des années 1950 : secret statistique et respect de la vie privée
Après la Deuxième Guerre mondiale, la relance économique et industrielle devient vite une réalité. L’informatique commence à se développer, même lentement : en juin 1968, il y a 3268 ordinateurs en France. Les mathématiques appliquées se développent, des entreprises (EDF, Air France, etc) créent les premiers départements de Recherche Opérationnelle ; en été 1956, la dénomination « intelligence artificielle » naît lors du Congrès de Dartmouth, aux Etats-Unis. En outre, les réflexions conduisant à Internet et au numérique, apparues dès 1945, deviennent peu à peu réalité dans les années 60 : l’e-mail date de 1971, le protocole TCP/IP de 1978, Microsoft est fondée en 1975, Apple en 1976 (Bush [4], Licklider [11]).
La révolution qui débute va soulever de nouvelles questions de secret, de sécurité et de protection.
2.1 – La construction du cadre juridique
La loi de 1951
La statistique publique française se redéfinit et se structure avec l’apparition de l’INED en 1945 et de l’INSEE en 1946, atouts majeurs de la statistique publique française « moderne », dont les mots-clés sont recensement, classement (nomenclatures), mesure, évaluation, prévision, sans oublier les directions statistiques des divers ministères.
Dès 1951, droit et statistique se rapprochent par la loi n°51-711 du 7 juin portant sur l’obligation, la coordination et le secret en matière de statistiques publiques, avec la notion d’« impossibilité d’identification », l’interdiction de communiquer des données confidentielles obtenues par le service public, à l’exception de certaines finalités scientifiques ou historiques.
Ainsi, pour les personnes physiques, les données personnelles, familiales, privées sont interdites de communication dans un délai de soixante-quinze ans. Dans le cas des entreprises, aucun résultat ne peut être obtenu par cumul pour un périmètre de moins de trois entreprises ou si une entreprise représente au moins 85 % de l’indicateur faisant l’objet de l’agrégation. Croiser un secteur d’activité à un niveau fin, une taille d’entreprise et des critères d’exportation n’est donc pas toujours possible.
La loi de 1951 concerne la statistique publique ; son importance est néanmoins majeure car elle a introduit des notions qui seront ultérieurement reprises et étendues, et elle a apporté aux personnes répondant aux enquêtes des premières garanties de confiance.
La loi de 1978
La fin des années 1960 et le début des années 1970 sont marqués par le développement de l’informatique, de la recherche opérationnelle et de l’intelligence artificielle.
En 1974, apparaît un projet appelé Safari (Système automatisé pour les fichiers administratifs et le répertoire des individus) dont l’objectif est de mettre en connexion les fichiers nominatifs des administrations.
La réflexion sociétale et politique qui s’ensuit conduit à la loi n°78-17 du 6 janvier 1978 relative à l’informatique, aux fichiers et aux libertés. Celle loi fixe les règles de protection de la vie privée dans l’usage de fichiers de données à caractère personnel (DCP), et crée la Commission nationale de l’informatique et des libertés (CNIL), autorité administrative indépendante.
La mission de la CNIL est initialement d’éviter que l’informatique nuise à la vie privée des citoyens et citoyennes, à leurs libertés individuelles et publiques. L’arrivée d’internet et des big data est à l’origine d’aménagements ultérieurs de la loi de 1978.
2.2 – Protéger données et individus
Dans les années 70, avec la confirmation de l’informatique, des modèles de comportement et de leur validation via les « bases de données » (on ne parle pas encore des big data car le monde numérique n’existe pas encore au niveau du grand public), deux approches naissent, complémentaires, pour protéger les données et ceux qui les engendrent : les techniques et les règles juridiques.
A – La protection mathématique des data
Le précurseur s’appelle Tore Dalénius (1917-2002). Il travaille à l’Institut de Statistique suédois et s’intéresse à diverses questions statistiques relevant de l’échantillonnage ou de la participation à une base de données (Dalenius [6]).
Sur ce dernier sujet, Dalenius postule le principe suivant, qui semble bien naturel :
« Accéder à une base de données ne doit pas permettre d’apprendre plus de choses sur un individu que ce qui pourrait être appris sans accès à cette base de données. »
Ainsi, si X(i) est la valeur d’une variable X pour l’individu répondant i, et si la publication d’un agrégat statistique T permet de déterminer la valeur X(i) plus précisément que sans accès à T, alors il y a faille de confidentialité.
Ce principe est rapidement mis en défaut par l’existence d’information auxiliaire. Par exemple, considérons une base de données contenant les tailles d’échantillons d’hommes adultes de plusieurs nationalités, dont l’Italie. Nous disposons d’une information auxiliaire : « l’individu J fait 2 cm de plus que l’italien moyen ». On en déduit donc immédiatement la taille de J.
Le seul accès à l’information auxiliaire donne peu d’éléments sur l’individu J, et le résultat d’impossibilité ne dépend pas du fait que J contribue à la base de données ou pas.
Un théorème établit que si S désigne un mécanisme de protection d’une base de données et F une faille dans cette protection. Pour toute base de données, il existe toujours une information auxiliaire Z telle que Z toute seule n’a pas d’utilité pour un « adversaire », mais Z combinée avec les données protégées permet de trouver dans S une faille F avec une probabilité qui tend vers 1.
Divers travaux vont être menés pour tenter de protéger « techniquement » les informations personnelles contenues dans une base de données.
Citons-en quelques-unes :
a) l’anonymisation, qui consiste à enlever de la base toutes les variables permettant d’identifier directement le répondant.
Nous reviendrons au §3 sur la distinction entre ano et pseudo-nymisation. Car d’autres variables peuvent permettre, par recoupement, de retrouver un individu dans un ensemble, même imparfaitement. La loi de probabilité de bonne identification s’éloigne de plus en plus de la loi uniforme considérée alors comme la loi de « l’ignorance parfaite », c’est-à-dire la « meilleure » protection,
b) la destruction des données, comme la suppression après une période conventionnelle,
c) l’agrégation, qui consiste à regrouper les données individuelles en résultats agrégés ; mais les performances des modèles mathématiques permettent une inférence individuelle inversée (Homer et al. [10], Sweeney et al. [19]),
d) l’obscurcissement des données, c’est-à-dire leur altération. Il y a les techniques non perturbatrices, comme masquer la valeur de certaines cellules dans un tableau de résultats, enlever des variables pour certains individus, partager seulement un échantillon de données extrait de la base générale de données, etc ; existent également des méthodes directement interventionnistes sur les données, comme modifier certaines variables numériques en les arrondissant, ou encore les transformer par des homomorphismes, ou en les bloquant par troncature à des seuils maximum ou minimum; on peut aussi permuter les valeurs d’une même variable entre deux répondants, ou perturber les données par un « bruit » b, c’est-à-dire remplacer la variable X par X + b où b est aléatoire,
e) La confidentialité différentielle
Cette notion est introduite par Cynthia Dwork de Microsoft Research et professeur affiliée à Harvard (Dwork [7]). Sa philosophie est que :
« la probabilité d’une conséquence négative quelconque pour l’individu i – par exemple le fait que i se voie refuser un crédit, ou une assurance – ne peut augmenter significativement en raison de la participation de i à une base de données ».
Son idée est de quantifier le risque de faille dans la promesse de confidentialité, tout en mesurant précisément l’effet de la protection des données et de la vie privée sur la qualité des résultats et analyses statistiques, pour pouvoir promettre à une personne appartenant à une base de données qu’une tierce partie (« l’adversaire ») ne pourra rien apprendre de plus sur elle, qu’elle participe à la base ou non.
B – Le cadre juridique de protection
Revenons à la loi de 1978.
Une donnée à caractère personnel (DCP) est définie comme étant « toute information relative à une personne physique identifiée ou qui peut être identifiée, directement ou indirectement, par référence à un numéro d’identification ou à un ou plusieurs éléments qui lui sont propres ».
Ces DCP peuvent être conservées brutes ou traitées.
Un traitement est défini de façon large comme toute opération ou ensemble d’opérations sur des DCP … notamment la collecte, l’enregistrement, l’organisation, la conservation, l’adaptation ou la modification, l’extraction, la consultation, l’utilisation, la communication par transmission, diffusion ou toute autre forme de mise à disposition, le rapprochement ou l’interconnexion, ainsi que le verrouillage, l’effacement ou la destruction.
La notion de traitement dépasse le langage commun puisque la notion-même de collecte en fait partie : recueillir une donnée auprès d’une unité d’observation (individu, ménage, entreprise, etc.) – donc la faire « changer de sphère » – sans lui faire subir la moindre altération est déjà un traitement.
L’enjeu n’est plus seulement la pertinence et la qualité des données recueillies, mais son effet normatif par l’emploi de modèles d’une complexité croissante. Données et modèles peuvent conduire à des décisions ayant des conséquences juridiques ou quasi-juridiques : refus, contrôle, exclusion, surcoût, priorisation ou surveillance.
La statistique ne sert plus seulement à décrire et à connaître, mais à classer, prédire ou décider : scoring bancaire, tarification assurantielle, détection et ciblage antifraude, recrutement en RH, notation de risque, orientation scolaire, attribution d’aides, contrôle fiscal, police prédictive. Il ne faut plus alors seulement protéger le secret des données mais lutter contre l’usage décisionnel des données et de leurs traitements.
Dans cette logique, l’article 10 stipule qu’« aucune décision de justice impliquant une appréciation sur le comportement d’une personne ne peut avoir pour fondement un traitement automatisé de DCP destiné à évaluer certains aspects de sa personnalité. Aucune autre décision produisant des effets juridiques à l’égard d’une personne ne peut être prise à partir d’un traitement automatisé de données destiné à définir son profil ou à évaluer des aspects de sa personnalité ».
3 – Internet, numérique et big data
L’offre internet pour le grand public apparaît en 1994. Il faudra quelques années pour que la notion de mass-média s’applique : équipement des ménages en ordinateurs, explosion de la « bulle financière internet » en 2000 (et assainissement), apparition du web 2.0, blogs, premiers réseaux et aménagements de l’offre, et surtout la création des objets que sont le smartphone en 2007 et la tablette en 2010. En 2000, seuls 5 % des ménages français ont accès au web.
Point central du dispositif, la loi « informatique et libertés » fait l’objet d’une première évolution le 6 août 2004, notamment sur la notion de données personnelles, neuf ans après la directive 95/46/CE du Parlement européen en date du 24 octobre 1995, portant sur la protection des personnes physiques à l’égard du traitement des données à caractère personnel et à la libre circulation de ces données. En même temps, les prérogatives de la CNIL dans ses missions d’investigation, d’enquête et de sanction sont accrues.
a) Décennie 2010
La décennie 2010 est marquée par diverses réflexions et fortes avancées.
Une première, comme mentionné précédemment, concerne le passage de la seule protection des données à la notion de traitement.
Le « droit des algorithmes » commence à être régulièrement cité. En témoigne la publication par le Conseil d’Etat, en septembre 2014, de « Le numérique et les droits fondamentaux », contenant cinquante propositions portant sur le numérique, les droits individuels et l’intérêt général (Conseil d’Etat [5]).
Ci-après un extrait concernant les « algorithmes prédictifs » (à mettre en lien avec la loi de 1978) :
1 – Pour assurer l’effectivité de l’interdiction de fonder une décision sur la seule mise en œuvre d’un traitement automatisé, confirmer que l’intervention humaine dans la décision doit être réelle et pas seulement formelle
2 – Imposer aux auteurs de décisions s’appuyant sur des algorithmes une obligation de transparence sur les données personnelles utilisées par l’algorithme et le raisonnement général suivi par celui-ci. Donner à la personne faisant l’objet de la décision la possibilité de faire valoir ses observations
3 – Dans le cadre de l’article 44 de la loi du 6 janvier 1978 et dans le respect du secret industriel, développer le contrôle des algorithmes par l’observation de leurs résultats, notamment pour détecter des discriminations illicites, en renforçant à cette fin les moyens humains dont dispose la CNIL.
Une deuxième grande évolution, au niveau européen, est l’adoption par le Parlement européen, le 27 avril 2016, du Règlement Général sur la Protection des Données (RGPD), avec une date d’entrée en vigueur au 25 mai 2018. Son objectif est, dans le cadre du Marché Unique Numérique de l’Europe, d’avancer vers une harmonisation des dispositions prises par chaque Etat en matière de protection. Les mots-clés sont protection, bien évidemment, mais aussi transparence, privacy by design, ainsi que sécurité et sanction.
Les personnes doivent être informées des objectifs des traitements réalisés à partir de leurs data, et la notion de consentement explicite apparaît, en même temps que des droits : droit d’accès, de rectification, d’opposition, de suppression, de limitation du traitement, etc.
Le titre de DPO (Data Protection Officer, ou Délégué à la Protection des Données) incite les organisations à formellement se structurer autour du concept de protection. Le RGPD impose la mise en œuvre opérationnelle de toutes les mesures techniques, organisationnelles (process) ou de communication pour que soient assurées la disponibilité, l’intégrité, la confidentialité et la traçabilité des DCP.
Très vite, les Universités créent des diplômes universitaires de DPO ou de DTN (Droit et Technologies Numériques).
Dans le contexte RGPD, une troisième grande étape est la sortie, le 7 octobre 2016, de la loi pour une République numérique (parfois dénommée « loi Axelle Lemaire », alors secrétaire d’Etat au numérique). Elle est précédée, une grande première, d’une consultation numérique publique en 2015.
Très amitieuse, cette loi porte, bien naturellement, sur la protection des DCP, mais aussi sur l’open data, la neutralité du net, les logiciels libres, l’accès au numérique pour toutes et tous, ou encore la « mort numérique », c’est-à-dire le devenir des données d’une personne suite à sa mort.
Autre suite au RGPD : la loi « informatique et libertés » est à nouveau modifiée le 20 juin 2018 en cohérence avec le règlement européen.
b) Anonymisation et pseudonymisation
Nous avons évoqué l’anonymisation au § 2.2, A ; droit et techniques statistiques se retrouvent sur ce nouveau territoire.
Le RGPD a donné un véritable statut juridique aux procédures d’anonymisation, puisque les données anonymisées ne sont plus considérées comme des données personnelles, et donc ne sont plus soumises aux règles du RGPD. L’anonymisation est censée être irréversible.
Le RGPD a introduit la pseudonymisation, qui recouvre l’ensemble des techniques rendant impossible l’identification individuelle sans intervention d’informations exogènes.
Néanmoins, l’évolution des modèles rend possible qu’à terme la probabilité de réidentification augmente. Le droit oblige donc à penser la statistique non seulement comme un résultat, mais comme un environnement de données : données supplémentaires, modèles de traitement.
4 – Maintenant et demain : IA, droit d’auteur, etc.
L’arrivée de l’IA et de ses potentiels a renforcé le lien entre droit et statistique. Certes, l’IA fête en 2026 son soixante-dixième anniversaire ; les systèmes experts, le learning existent depuis la fin du XXème siècle. Mais l’arrivée de l’IA générative a introduit une démocratisation inédite, sa facilité d’usage immédiat faisant très souvent oublier – effet d’atrophie cognitive – ses fondements statistiques présents dans les modèles LLM (Belliat, Morgensztern [3]).
L’Union Européenne s’est emparée de ce nouveau domaine dès octobre 2020, et l’adoption d’une résolution votée à une très grande majorité.
Citons-en deux extraits. Le premier émet des principes directeurs que l’on pourrait résumer par le fait que l’homme doit, en toutes circonstances, « garder la main sur la machine », même si cette dernière est enrichie et augmentée par une IA. Ces axes majeurs sont : « une intelligence artificielle centrée sur l’humain et développée par l’homme ; la sécurité, la transparence et la responsabilité ; des garanties contre les préjugés et la discrimination, le droit de recours, la responsabilité social et environnementale ; le respect de la vie privée et de la protection des données. »
Le second extrait précise que « les technologies d’IA à haut risque, telles que celles dotées de capacités d’auto-apprentissage, devraient être conçues de manière à permettre un contrôle humain à tout moment. Dans le cas où l’utilisation d’une fonctionnalité entrainerait une violation grave des principes éthiques et pourrait être dangereuse, les capacités d’auto-apprentissage devraient être désactivées et un contrôle humain total devrait être rétabli. »
La réflexion s’est poursuivie et a conduit à l’adoption, en mars 2024, du règlement européen sur l’intelligence artificielle (AI Act), entré en vigueur au 1er août 2024, reconnaissant que les systèmes d’IA comportent des risques, classés en quatre niveaux, et qu’ils reposent sur des méthodes statistiques ou probabilistes.
Bibliographie
[1] Armatte Michel, Droesbeke Jean-Jacques, Quetelet, l’œuvre probabiliste, Ined Editions, Paris, 2023
[2] Barbin Evelyne, Marec Yannick, Les recherches sur la probabilité des jugements de Simon-Denis Poisson, Histoire & Mesure, Vol. 2, n°2, 1987
[3] Belliat Zysla, Morgensztern Mathieu, L’IA générative : une histoire de mathématiques, Variances.eu, 2026
[4] Bush Vannevar, As we may think, The Atlantic, Washington, July 1945
[5] Conseil d’Etat, Le numérique et les droits fondamentaux, La Documentation Française, 2014
[6] Dalenius Tore, Towards a methodology for statistical disclosure control, Statistik Tidskrift, Vol. 15, 1977
[7] Dwork Cynthia, Differential Privacy, Proceedings of the 33rd International Colloquium on Automata, Languages and Programming, 2006 https://link.springer.com/chapter/10.1007/11787006_1
[8] Faure Fernand, La statistique dans les Facultés de droit, Revue Internationale de l’Enseignement, Tome 22, 1891
[9] Garapon Antoine, Lassègue Jean, Justice digitale, PUF, Paris, 2019
[10] Homer Nils, Szelinger Szabolcs, Redman Margot, et alii, Resolving individuals contributing trace amounts of DNA to highly complex mixtures using high-density SNP genotyping microarrays, Plos Genetics, Août 2008
[11] Licklider Joseph, The computer as a communication device, Science and Technology, Avril 1968
[12] Melot Romain, Pelisse Jérôme, Prendre la mesure du droit : enjeux de l’observation statistique pour la sociologie juridique, Droit et société, n°2, 2008
[13] Poisson Siméon Denis, Recherches sur la probabilité des jugements en matière criminelle et en matière civile, Ed. Bachelier, Paris, 1837
[14] Rouvroy Antoinette, Des données sans personne : le fétichisme de la donnée à caractère personnel à l’épreuve de l’idéologie des big data, in Le numérique et les droits fondamentaux, Etude annuelle 2014 du Conseil d’Etat, La Documentation Française, 2014
[15] Rouvroy Antoinette, La gouvernementalité algorithmique, Colloque ENSAE Alumni « Intelligence Artificielle : fiction ou actions ? », 15 mars 2018, Variances.eu
[16] Schneps Leila, Statistiques, probabilités et justice, in Cahiers philosophiques, n°155, 2018
[17] Singh Simon, Le dernier théorème de Fermat, Hachette, Paris, 1999
[18] Singh Simon, Histoire des codes secrets, Jean-Claude Lattès, Paris, 1999
[19] Sweeney Latanya, Abu Akua, Winn Julia, Identifying participants in the Personal Genome Project by name, computer science, avril 2013
[20] Verdier Henry, Missika Jean-Louis, Le Business de la haine : Internet, la démocratie et les réseaux sociaux, Calmann-Lévy, Paris, 2022)
[21] Willmann Christophe, Des chiffres et des règles à propos du droit et de la statistique, in « Science, éthique et droit », sous la direction de Nicole Le Douarin et Catherine Puigelier, Odile Jacob, Paris, 2007
Dossier Statistiques 2 – Sommaire :

Philippe Tassi a été professeur-chercheur à l’Ensae, DGA de Médiamétrie, et est actuellement membre de la Commission Nationale des Sondages
- Droit et statistique : une liaison plus que centenaire - 6 novembre 2026
