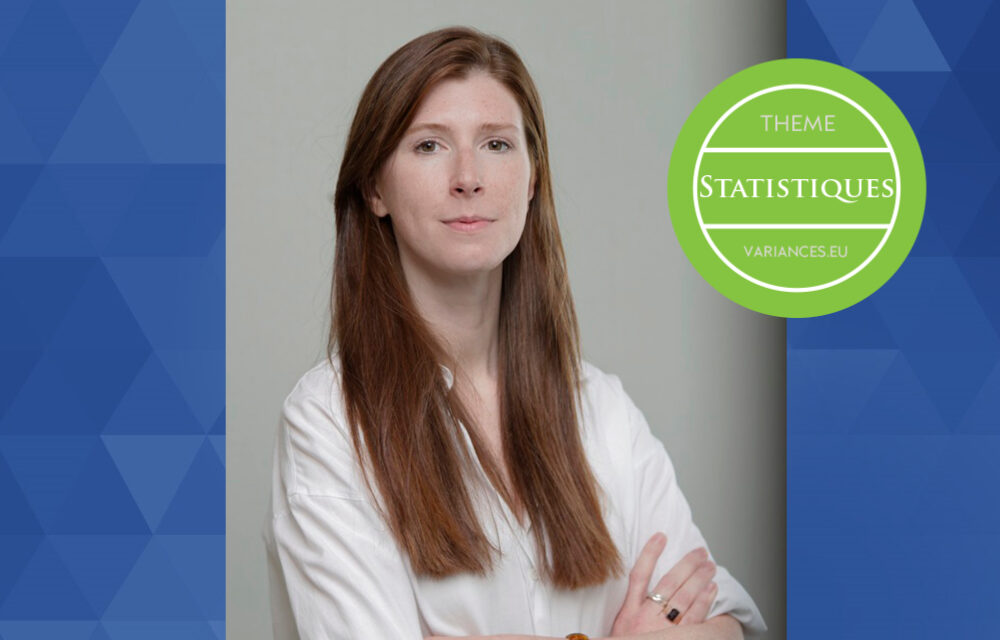
Professeure à l’ENSAE et chercheuse au CREST, Anna Korba est lauréate 2026 de la médaille de bronze[1] du CNRS pour ses travaux novateurs en apprentissage automatique. Ses recherches portent notamment sur l’optimisation dans des espaces de mesures de probabilité et ont conduit à des avancées théoriques importantes, avec des applications en échantillonnage et en modèles génératifs.
L’entretien qui suit est essentiellement la traduction de celui publié en anglais par le CREST (CRESTive Minds), avec l’ajout d’éléments d’actualité (CNRS).
***
Quel a été votre parcours avant de rejoindre l’ENSAE/CREST ?
Je me suis intéressée assez tôt aux mathématiques, car j’aimais à la fois leur côté rigoureux et profondément créatif. J’ai suivi une formation en mathématiques et en science des données à l’ENSAE, en parallèle d’un master en apprentissage automatique (Machine Learning) à l’ENS Cachan.
J’ai ensuite poursuivi dans ce domaine avec une thèse à Télécom Paris, avant de partir en post-doctorat à University College London, au sein de Gatsby Computational Neuroscience Unit. J’ai rejoint l’ENSAE et le CREST en 2020 en tant que professeure assistante, titularisée professeure en 2026.
Pourquoi l’apprentissage automatique plutôt que d’autres domaines mathématiques ?
Étudiante, j’aimais les mathématiques et la programmation. À l’ENSAE, j’avais le choix entre la finance quantitative et l’apprentissage automatique. D’une part, les recrutements en finance quantitative ralentissaient. D’autre part, j’ai choisi l’apprentissage automatique, attirée par la richesse mathématique de ce domaine, par son potentiel d’innovation et la multitude d’applications pratiques. J’ai aussi été très inspirée par l’excellence de l’enseignement en mathématiques dispensé à l’ENSAE par des professeurs comme Arnak Dalalyan, Nicolas Chopin ou Cristina Butucea que j’ai eus en cours.
Est-ce qu’un statisticien, une statisticienne vous a particulièrement inspirée ?
Davantage collectivement qu’à titre vraiment individuel. Je me souviens très bien de ma première conférence internationale en apprentissage automatique (ICML 2015 à Lille). Assister aux présentations au sein de la communauté de l’apprentissage profond, bien qu’un peu éloigné de mes thèmes de recherche de l’époque, m’a profondément marquée. J’ai été fascinée par les progrès rapides et considérables réalisés, notamment dans des domaines comme la réponse aux questions (l’ordinateur est interrogé sur un texte qu’il prenait en entrée, le but étant de voir s’il en avait compris les informations). Les conférences auxquelles j’ai participé m’ont permis de rencontrer un collectif de personnalités influentes, des professeurs émérites aux brillants doctorants, et d’enrichir ainsi ma vision sur de multiples aspects de la statistique et de l’apprentissage automatique.
Quels sont vos principaux sujets de recherche aujourd’hui ?
Mes travaux se situent à l’interface des mathématiques, de la statistique et de l’intelligence artificielle. Je m’intéresse principalement à des problèmes d’optimisation dans des espaces de mesures de probabilité, en mobilisant des outils comme le transport optimal ou les méthodes à noyaux. Un de mes axes principaux de recherche concerne l’échantillonnage de distributions de probabilité cibles, souvent en très grande dimension, à partir d’informations partielles. Il s’agit en particulier de comprendre les propriétés théoriques des algorithmes utilisés et de garantir leur convergence. Ce problème polyvalent trouve des applications dans des secteurs variés, de la biologie computationnelle, à la physique, en passant par les industries créatives.
En inférence Bayésienne, j’étudie la distribution de probabilité a posteriori des paramètres d’un modèle d’apprentissage supervisé, par exemple ceux d’un réseau de neurones. Par ailleurs, en modélisation générative, mes travaux consistent à apprendre la distribution de probabilité sous-jacente de données (par exemple, un ensemble d’images trouvées sur le web) à partir d’un ensemble d’échantillons, afin d’en générer de nouvelles (par exemple, générer de nouvelles images réalistes).
Outre l’échantillonnage, je travaille aussi sur l’apprentissage des préférences, par exemple pour analyser les choix d’utilisateurs au sein d’un ensemble de biens.
L’échantillonnage et l’approche bayésienne présentent un enjeu particulier en apprentissage automatique ?
Beaucoup de problèmes en intelligence artificielle reviennent à savoir échantillonner, c’est-à-dire générer des échantillons d’une distribution de probabilité, soit pour l’approcher, soit pour générer de nouvelles données. En apprentissage automatique Bayésien, on peut modéliser l’incertitude des prédictions en échantillonnant les paramètres du modèle. C’est essentiel dans de nombreuses applications comme la modélisation scientifique ou certaines décisions automatisées, qui nécessitent une compréhension plus fine que les seules prédictions ponctuelles. Par ailleurs, l’agrégation des prédictions obtenues via ces paramètres échantillonnés (autrement dit, le moyennage de modèles) permet d’accroître significativement la robustesse des résultats.
Votre domaine de recherche est relativement récent et semble très interdisciplinaire. En quoi est-ce la source d’avancées majeures ?
Mes recherches se situent en effet à l’intersection de diverses communautés, notamment des experts en méthodes MCMC (méthodes de Monte Carlo par chaînes de Markov), en équations aux dérivées partielles, systèmes dynamiques, transport optimal et en apprentissage automatique. Ces dernières années, les frontières entre ces domaines traditionnellement indépendants se sont estompées et sont devenues plus fluides, ce qui a stimulé les collaborations et les progrès. Les conférences et ateliers rassemblant des chercheurs de ces domaines se multiplient, où des compétences variées mettent à profit leurs expertises respectives pour relever les défis. Cette effervescence collaborative a permis des avancées remarquables, tant sur le plan théorique que computationnel. Par exemple, en termes de garantie de convergence des schémas numériques ou encore de limitations pratiques telles que le temps de convergence et les minima locaux.
De nombreux problèmes restent sans doute encore à résoudre. Quels aspects comptez-vous aborder ou développer dans vos futures recherches ?
Bien que des progrès significatifs aient été réalisés dans les techniques d’échantillonnage inspirées de la littérature sur l’optimisation, de nombreux aspects demeurent inexplorés. Une partie de ma recherche actuelle porte sur l’intégration de contraintes dans les méthodologies d’échantillonnage. Par exemple, j’étudie des moyens de garantir l’équité des modèles prédictifs en contraignant la distribution a posteriori, ce qui permet de réaliser des prédictions indépendantes d’attributs sensibles comme le genre. Dans le domaine de la modélisation générative, il est également intéressant d’intégrer des contraintes ou des préférences, par exemple pour générer des images répondant à un critère tel que la luminosité.
Vous avez d’ailleurs obtenu en 2025 une bourse ERC[2] Starting Grant pour le projet OptInfinite. Quel est son objectif ?
OptInfinite (Optimisation en dimension infinie) ambitionne de bâtir un cadre théorique et pratique unifié s’appuyant sur des outils de transport optimal et de géométrie de l’information. Le but est de concevoir des méthodes d’échantillonnage plus efficaces et capables de s’adapter à des espaces variés, bien au-delà des données vectorielles. Les méthodes actuelles montrent vite leurs limites lorsqu’il s’agit de distributions complexes de grande dimension ou lorsqu’on doit résoudre des problèmes d’échantillonnage ou de génération successifs, car elles restent en particulier très coûteuses en calcul. Pour dépasser ces obstacles et atteindre l’efficacité numérique, nous explorons une approche par optimisation de mesures de probabilité, qui permet de manipuler directement des distributions plutôt que de simples nombres ou vecteurs dans un espace Euclidien de dimension finie. À terme, l’objectif du projet est de fournir une véritable boîte à outils applicable à de multiples domaines, pour mieux comparer, manipuler et générer des données complexes.
Vous venez de recevoir la médaille de bronze du CNRS. Que représente cette distinction pour vous ?
C’est une reconnaissance importante de mon travail, ainsi que celui de mes collègues Cela me touche beaucoup et me motive à poursuivre mes recherches en explorant de nouvelles idées.
Quel message aimeriez-vous transmettre aux jeunes qui souhaitent se lancer dans la recherche ?
On a parfois l’image que la recherche est réservée à des génies, mais ce n’est pas le cas. La curiosité, le goût pour les questions et la persévérance sont bien plus importants dans les parcours scientifiques. La dimension collective de la recherche revêt également une importance fondamentale, j’ai toujours énormément appris de mes collaboratrices et collaborateurs. Aujourd’hui, avec la montée en puissance de l’IA pour la résolution de problèmes mathématiques, cela me paraît être d’autant plus le cas. Je suis persuadée que nous aurons encore besoin de chercheurs en mathématiques dans le futur, même si le métier est en train de changer.
[1] Récompense des travaux prometteurs en début de carrière.
[2] European Research Council. Décernées par le Conseil européen de la recherche (ERC), les bourses Starting Grants récompensent de jeunes chercheurs (deux à sept ans après le doctorat) et soutiennent des projets de recherche de rupture visant à repousser les frontières de la connaissance. Le seul critère de sélection est l’excellence scientifique.
Dossier Statistiques 2 – Sommaire :
- Entretien avec Anna Korba (2015) - 6 novembre 2026
